ROI von Predictive Maintenance in der Handelsschifffahrt: ein praxisnaher Rahmen
Predictive Maintenance, kurz PdM, ist seit fast einem Jahrzehnt ein Modewort in der Schifffahrt. Anbieterpraesentationen versprechen zweistellige Senkungen ungeplanter Stillstaende, deutliche Schnitte beim Ersatzteilbestand und Maschinenraeume, die sich praktisch selbst betreiben. Auf den meisten Handelsschiffen sieht die Wirklichkeit nuechterner aus: planmaessige Wartungssysteme, die auf Betriebsstunden und Kalenderintervallen aufbauen, sind weiterhin das dominierende Betriebsmodell, und die kulturelle und vertragliche Schwerkraft dahinter verschiebt sich nicht schnell.
Das heisst nicht, dass PdM eine Fata Morgana ist. Es heisst, dass Superintendents, Fleet Manager und Leitende Ingenieure einen Rahmen brauchen, der jene Anlagengruppen, in denen sich Condition-based Monitoring tatsaechlich rechnet, von jenen unterscheidet, in denen es zur teuren Ablenkung wird. Dieser Beitrag stellt einen solchen Rahmen vor, verankert in den Normen und Klasseprogrammen, die die Arbeit ohnehin strukturieren.
Was Predictive Maintenance an Bord wirklich bedeutet
Der Begriff wird locker verwendet. Im maritimen Kontext ist es sinnvoll, vier Ideen sauber zu trennen, alle innerhalb des ISO 13374 Schirms fuer die Verarbeitung von Zustandsdaten.
- Zustandsorientierte Instandhaltung (CBM): die Instrumentierung liest den realen Zustand des Assets (Vibration, Oelqualitaet, Abgastemperatur, elektrische Signatur) und loest Eingriffe aus, sobald Schwellen ueberschritten werden.
- Reliability-centred Maintenance (RCM): eine strukturierte Analyse von Ausfallarten und Folgen (FMEA-Logik), die anzeigt, welche Assets CBM verdienen und welche besser mit Run-to-Failure oder festen Intervallen gefahren werden.
- Diagnose mit digitalem Zwilling: ein kalibriertes Modell des Assets, das mit Live-Telemetrie gespeist wird und interne Zustandsgroessen ableitet, die nicht direkt messbar sind (Verbrennungsbalance, Lagerspiel, Buechsenverschleiss).
- Anomalieerkennung in Sensorstroemen: statistische oder maschinell lernende Modelle, die Abweichungen von der historischen Normalhuelle markieren, ohne die Ursache zwingend zu erklaeren.
Diese Ansaetze ergaenzen einander, sie sind nicht austauschbar. Reine Anomalieerkennung ohne RCM-Skelett produziert Alarme, denen niemand vertraut. Ein digitaler Zwilling ohne disziplinierte CBM-Schwellen produziert huebsche Dashboards, die niemand bedient.
Warum klassisches PMS noch dominiert, und wo es scheitert
Das klassische Planned Maintenance System, dem Geist nach durch den ISM Code gefordert und durch die Klasse auditiert, basiert auf Betriebsstundenzaehlern und kalendarischen Intervallen des OEM. Es ist einfach, vor Port State Control und Klasseinspektionen verteidigbar und passt zur Crewrotation. Fuer viele unkritische Anlagen ist es ausserdem aufrichtig ausreichend.
Seine Schwaechen sind jedem bekannt, der eine Flotte einige Jahre gefuehrt hat.
- Intervalle laufen am realen Zustand vorbei. Eine Top Overhaul der Hauptmaschine bei der OEM-Empfehlung kann auf einem Schiff mit stabilem Brennstoff und gutmuetigen Lastprofilen verfrueht sein, auf einem Schiff, das zwischen Hochschwefel und VLSFO mit haeufigem Manoevrieren wechselt, ueberfaellig.
- Intervalle blind zu folgen, kostet. Ersatzteile, Dock-Slots und Crewstunden werden an Anlagen verbrannt, die keinen Eingriff brauchten.
- Es uebersieht die teuren Ausreisser. Lagerschaeden, Turbo-Fresser, Wicklungsfehler an Generatoren, Ausrichtungsprobleme der Welle — genau die Ereignisse, die Versicherungsfaelle und Off-Hire treiben — kuendigen sich selten im Kalender an.
Die ehrliche Rahmung lautet nicht PdM gegen PMS. Es ist ein Hybrid, in dem ein diszipliniertes PMS die regulatorische und vertragliche Wirbelsaeule bleibt und PdM auf den Anlagengruppen aufgesetzt wird, deren Ausfallarten es rechtfertigen.
Wo Predictive Maintenance tatsaechlich ROI liefert
Zwei Bedingungen muessen erfuellt sein, damit sich PdM auf einem Handelsschiff rechnet: der Ausfall muss teuer genug sein, dass seine Vermeidung zaehlt, und die Sensorsignale muessen reif genug sein, um ihn mit vertretbarer Sicherheit zu erkennen.
Diese Schnittmenge existiert, und auf den meisten Schiffen lebt sie in derselben Handvoll Anlagengruppen:
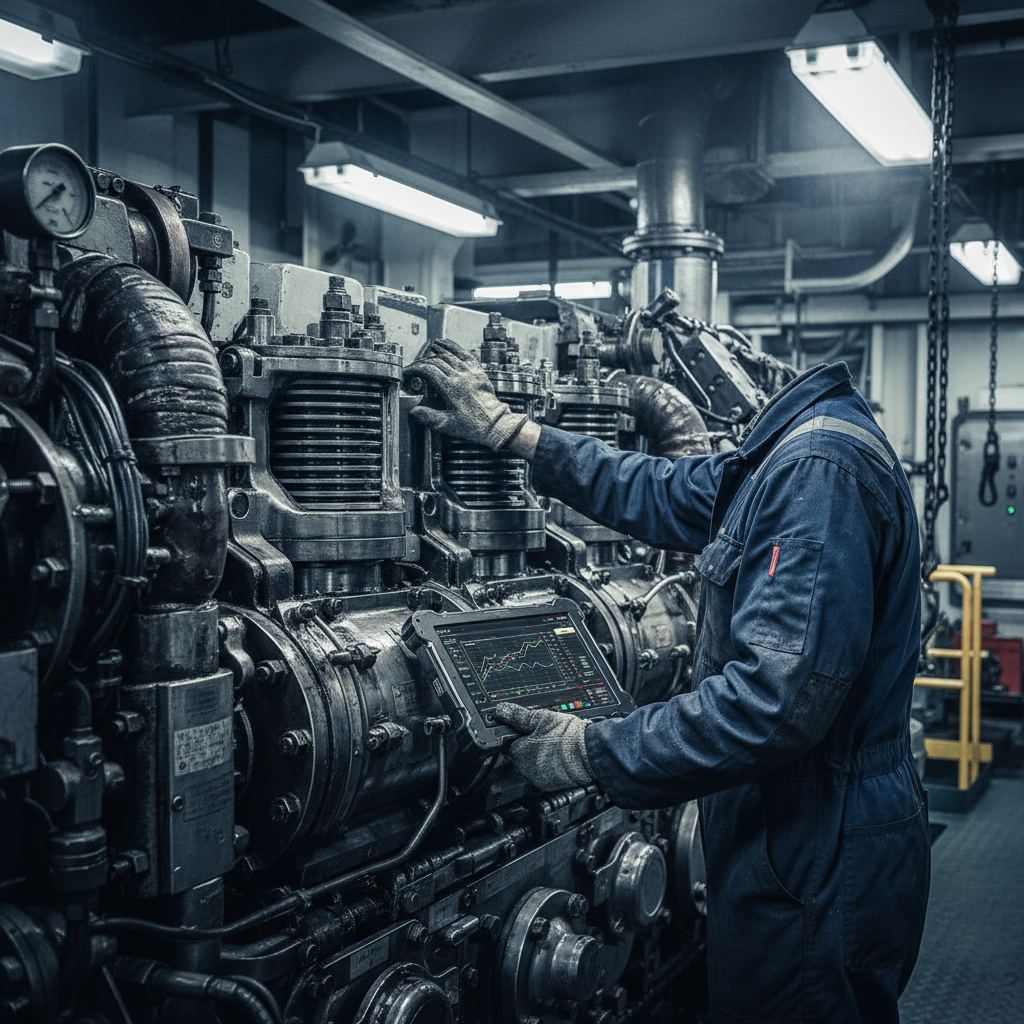
- Hauptmaschinen: Zylinderdruck, Abgastemperaturen, Spueldruecke und Schmieroelanalyse sind gut instrumentiert, und die Ausfallarten (Verbrennungsunwucht, Ringspiel, Buechsenverschleiss) sind tief charakterisiert. OEM-Portale wie MAN PrimeServ Assist und Wartsila Genius Services verfeinern diese Modelle seit Jahren.
- Wellenstrang und Lager: Vibrationsueberwachung und Wellen-Ausrichtungstelemetrie erfassen Defekte Wochen vor hoerbaren Symptomen.
- Generatoren und Hauptschalttafeln: Stromsignaturanalyse, Teilentladungsmessung und Wicklungstemperaturprofile geben fruehe Warnungen vor Isolationsverschlechterung.
- Pumpen, Kompressoren und Separatoren: rotierende Maschinen mit stabilen Betriebszyklen und reifen Vibrationssignaturen sprechen gut auf CBM an.
Der gemeinsame Faden ist, dass es sich um grosse, folgenschwere rotierende Assets mit stabilen Betriebszyklen handelt, bei denen die Kosten eines Ausfalls (Off-Hire, Bergung, Umwelt) ein Vielfaches der Investition in Sensorik und Analytik betragen.
Wo es keinen ROI liefert
Genauso wichtig ist Ehrlichkeit darueber, wo sich PdM nicht rechnet. Mehrere Kategorien wirken auf einer Folie attraktiv und scheitern in der Praxis.
- Niedrigpreisige Komponenten. Filter, einfache Ventile, Dichtungen, Schlaeuche. Run-to-Failure oder fixe Intervallersetzung ist fast immer billiger als Instrumentierung.
- Anlagen mit unregelmaessigem Einsatz. Notgeneratoren, Rettungsbootmotoren, Festmacherwinden. Ihre Betriebszyklen sind zu sparsam, als dass ein statistisches Modell konvergieren koennte, und das Klasse-Regime deckt sie ohnehin durch periodische Pruefungen ab.
- Sensorarme Systeme. Aeltere Hilfsaggregate, Hydraulik, Deckmaschinerie auf historischer Tonnage. Sensorbaeume, marinegerechte Gehaeuse und Kabelfuehrungen nachzuziehen kann den Lebenszyklusschaden, den man verhindern wuerde, leicht uebersteigen.
- Ein-Schiff-Pilots ohne Population. PdM-Modelle brauchen eine Population aehnlicher Assets zum Lernen. Ein Pilot auf einer Klasse mit drei Schwesterschiffen kann konvergieren; ein Pilot auf einem Einzelmotor ohne Vergleichswerte selten.
Hier verdient sich RCM seinen Namen: es ist das Sichtungsinstrument, das eine Flotte daran hindert, alles zu instrumentieren und nichts zu lernen.
Das Datenproblem in der Infrastruktur
Die meisten Flotten entdecken beim Versuch, PdM zu operationalisieren, dass die Daten bereits vorhanden sind. Sie koennen sie nur nicht nutzen.
Ein typisches Handelsschiff fuehrt heute Sensorstroeme aus dem Alarm- und Ueberwachungssystem, dem OEM-Portal der Maschine, einem getrennten Vibrationssystem, der Flottensoftware an Land, der Noon-Report-Routine und einer langen Reihe von Excel-Sheets, die Superintendents pflegen. Jede Quelle hat eigene Zeitbasis, Namenskonvention und Zugriffspolitik. Ohne Vereinheitlichung konvergiert kein Modell, weil der Datensatz nie dasselbe Schiff zum selben Zeitpunkt abbildet.
Die ISO 19848, die Norm fuer Schiffsdatenkommunikation, existiert genau, um dieses Problem anzugehen. Sie definiert eine gemeinsame Kanal-Namensstruktur (ShipID/EquipmentID/Quantity), die Maschinen-, Navigations- und Ladungssystemen erlaubt, in einen einzigen Zeitreihenstrom zu schreiben. Die Verbreitung ist uneinheitlich, aber die Referenzarchitektur ist richtig: jedes PdM-Programm, das die Vereinheitlichung nicht zuerst loest, baut auf Sand.
Praktisch heisst das, die Datenebene als erstrangiges Lieferobjekt zu behandeln. Namenskonventionen, Zeitsynchronisation ueber Hersteller hinweg, Aufbewahrungsregeln und eine einzige kanonische Quelle an Land. Ohne diese Basis wird jedes neu trainierte Modell stillschweigend mit dem vorigen uneinig sein.
Bandbreite und Edge-Verarbeitung zaehlen ebenfalls. Viele Flotten fahren auf gemessenen VSAT-Budgets oder bescheidener LEO-Konnektivitaet, und jede rohe Vibrationsprobe an Land zu schieben ist weder noetig noch tragbar. Das pragmatische Muster ist Edge-Aggregation: Rohsignale an Bord fuer ein definiertes Aufbewahrungsfenster halten, Features und Ausnahmen kontinuierlich an Land schieben, und Rohfenster nur dann zurueckholen, wenn ein Modell oder ein Superintendent danach fragt. Dasselbe Prinzip gilt fuer die OEM-Portale: selektive Synchronisation relevanter Tags in den vereinheitlichten Speicher, keine pauschale Replikation.
Die menschliche und vertragliche Ebene
Technik ist die einfachere Haelfte eines PdM-Programms. Die schwierigere Haelfte ist das Betriebsmodell darum herum.
Die Crew ist der erste Stakeholder. Ingenieure werden Alarme, die sie nicht verstehen oder denen sie nicht vertrauen, nicht bedienen, besonders dann nicht, wenn das Bedienen ein Abweichen von dem im PMS bereits hinterlegten OEM-Intervall bedeutet. Ein glaubwuerdiger Rollout enthaelt einen klaren Eskalationspfad von der Anomalie ueber die verifizierte Diagnose bis zum Auftrag, mit benannter Verantwortung an Land fuer den Diagnoseschritt. Sonst stapeln sich Alarme im Dashboard und der Leitende Ingenieur kehrt zum Kalender zurueck.
Als Naechstes zaehlt die kommerzielle Ebene. Charterklauseln, Wartungsruecklagen und Off-Hire-Definitionen wurden nicht im Hinblick auf zustandsbasierte Entscheidungen verfasst. Reedereien, die ernsthaftes Tonnage auf PdM verlagern, muessen schliesslich aushandeln, wie eine durch CBM-Belege gestuetzte aufgeschobene Ueberholung unter dem Charter behandelt wird und wie Klasse-CBS-Atteste mit Leistungsklauseln des Technical Managers zusammenwirken. Nichts Unueberwindbares, aber es muss bewusst geregelt werden, nicht erst nach dem ersten verschobenen Trockendock entdeckt.
Schliesslich die OEM-Beziehung. Aus Sensorsignalen abgeleitete praediktive Erkenntnisse koennen Garantie- und Serviceregelungen verkomplizieren, besonders wenn das OEM-Portal selbst die Datenquelle ist. Die erfolgreichsten Flotten behandeln den OEM als Partner in der Diagnosekette, nicht als Blackbox, teilen Zustandsbewertungen und verhandeln Service-Intervalle auf Basis von Evidenz statt Plan. Das setzt voraus, dass die eigene Datenebene sauber genug ist, um vor dem OEM Bestand zu haben — ein weiterer Grund, die Vereinheitlichung nicht zu unterschaetzen.
Damit verbunden ist der Aufbau interner Diagnosekompetenz. Eine kleine Gruppe an Land, die Vibrationssignaturen interpretieren kann, Schmieroelbefunde gegen Lastprofile liest und auffaellige Trends mit dem OEM diskutieren kann, ist in der Praxis der Hebel, ueber den ein PdM-Programm vom Pilotstatus in den Routinebetrieb uebergeht. Ohne diese Kompetenz bleibt jede Anbietersoftware ein Werkzeug ohne Bediener, und die Flotte zahlt fuer Lizenzen, ohne den entsprechenden Erkenntniswert zu realisieren.
Die Sicht der Klassifikationsgesellschaften: von der Vorschrift zum Zustand
Die Klassifikationsgesellschaften sind weiter, als viele Reedereien wahrnehmen. DNV, Lloyd's Register, ABS, Bureau Veritas, ClassNK und RINA betreiben alle zustandsbasierte Besichtigungsschemata (verschieden CBS, CMS, MPMS oder aequivalent benannt), die Operatoren erlauben, vorgeschriebene Besichtigungen gegenueber einem dokumentierten Zustandsueberwachungsprogramm zu verschieben oder umzustrukturieren.
Zwei regulatorische Anker zaehlen fuer jedes PdM-Programm.
- Die IACS-Empfehlung 166 zur Cyberresilienz von Bordsystemen. PdM-Datenfluesse, die Maschinensteuerungen, integrierte Brueckensysteme oder Ferndiagnoselinks beruehren, fallen voll in den Geltungsbereich. Die Empfehlung ist fuer den Superintendent, der eine vernetzte Wartungsarchitektur entwirft, keine optionale Lektuere.
- Der ISM Code, der weiterhin die Mindestbasis des planmaessigen Wartungsregimes definiert, das PdM ergaenzt, nicht ersetzt. Die MARPOL- und MEPC-Anforderungen zur Brennstoffprobenahme bleiben vorschreibend und unabhaengig von jedem zustandsbasierten Schema.
Praktische Folge: ein glaubwuerdiges PdM-Programm ist auch eine Klasse-Geschichte. Einen Klassepartner zu waehlen, dessen CBS-Programm zu den geplanten instrumentierten Anlagengruppen passt, formt den ROI ebenso wie die Sensorik selbst.
Ein Fuenf-Schritte-Rahmen
Flotten, die PdM rentabel hinbekommen, folgen meist einer wiedererkennbaren Sequenz. Sie ist nicht glamouroes, aber reproduzierbar.
- Hochwertige Ausfallarten identifizieren. Eine FMEA in RCM-Manier ueber das Anlagenregister fahren. Ausfaelle nach erwarteten Jahreskosten ordnen (Off-Hire, Reparatur, Umwelt, Vertrag). Was unter der Schwelle liegt, geht zurueck zu PMS oder Run-to-Failure.
- Selektiv instrumentieren. Fuer die ueberlebenden Ausfallarten den minimalen Sensorsatz nach ISO 17359 spezifizieren. Der Versuchung widerstehen, alles zu instrumentieren, weil der Kabelbaum ohnehin laeuft.
- Daten vereinheitlichen. Einen einzigen Zeitreihenspeicher an Land etablieren, idealerweise an die Kanalbenennung der ISO 19848 angelehnt. Uhrabweichungen, Tag-Mappings und Aufbewahrung loesen, bevor irgendein Modell trainiert wird.
- Auf einer Schiffsklasse pilotieren. Eine Klasse mit mindestens drei Schwesterschiffen und sauberer Betriebshistorie waehlen. Den Pilot mindestens ueber einen vollstaendigen Docking-Zyklus laufen lassen, damit saisonale und lastbedingte Variationen in den Datensatz einfliessen.
- ROI-positive Faelle skalieren. Jeden Anwendungsfall vor dem Flotten-Rollout an einen dokumentierten Business Case binden. Faelle, die nicht konvertieren, abruesten. Negative Faelle als Befund, nicht als Misserfolg behandeln.
Die realistische ROI-Huelle
Ehrliche Zahlen zaehlen, weil die Glaubwuerdigkeit des gesamten Programms davon abhaengt, dass der erste Business Case vor einem CFO bestand hat.
Fuer gut instrumentierte Handelsflotten, die die Phasen Vereinheitlichung und Pilot kompetent abschliessen, liegt die realistische Huelle tendenziell in einer Bandbreite von etwa fuenf bis fuenfzehn Prozent Reduktion ungeplanter Stillstaende auf den Zielanlagengruppen, mit einer aehnlichen Groessenordnung an Einsparungen aus aufgeschobenen Ueberholungen auf denselben Anlagen. Ersatzteiloptimierung und Versicherungsentlastung steuern weitere, kleinere Inkremente bei.
Anbieteraussagen oberhalb von dreissig Prozent ueberlagern fast immer einen Selektionsbias: die Stichprobe sind die Assets, auf denen PdM funktioniert hat, nicht jene, auf denen es versucht wurde. Diese Zahlen als Referenzfall fuer Zielanlagen zu nehmen, ist vertretbar; sie als Flottenerwartung zu nehmen, nicht.
Wo SupaMaritime einzuordnen ist
SupaMaritime baut auf der Annahme, dass kommerzielle Operatoren kein weiteres Punkt-Tool wollen. Das Merchant-Modul vereint Flottenoperationen, Hafenagenturarbeit und Faehrbetrieb in einem einzigen Datenmodell, mit einer Datenebene, die fuer die Telemetrie ausgelegt ist, auf der jedes ernsthafte PdM-Programm aufbaut. Die Plattform ersetzt weder das OEM-Diagnoseportal noch das CBS-Schema der Klasse; sie ist das operative Gewebe darum herum.
Wer ein Predictive-Maintenance-Programm scopt und verstehen will, wie es neben dem Rest des kommerziellen Betriebs sitzt, findet im Merchant-Operations-Modul den richtigen Einstieg. Eine vollstaendige Sicht der Plattform liegt in der Modul-Uebersicht, und die Sicherheits- und Daten-Governance-Haltung, die jede vernetzte Wartungsarchitektur erfuellen muss, ist auf der Security-Seite dokumentiert. Predictive Maintenance ist keine Wunderwaffe, aber auf den richtigen Anlagen, mit der richtigen Datenbasis und dem richtigen Klassepartner gehoert sie zu den wenigen maritimen Technologiewetten, in denen Rahmen, Normen und Oekonomie zueinander passen.